Laporan Praktikum Ilmu Data terhadap Misi Pilpres 2024
Laporan praktikum kali ini akan mencoba menerapkan Sains Data (Data Science) untuk mengungkap kemiripan dan perbedaan pola dan wawasan misi tiga blok/kelompok kalimat. Blok kalimat sebagai bahan praktikum adalah Misi Capres 2024 sebagaimana tercantum di Komisi Pemilihan Umum (https://www.kpu.go.id/berita/baca/12129/visi-dan-misi-pasangan-calon-presiden-dan-calon-wakil-presiden-pada-pemilu-2024). Untuk menekan bias, label nama asli diganti menjadi alfabet.
Praktikum ini diharapkan memberi wawasan bagaimana Sains Data bisa mengungkap apa yang tersirat pada teks mengenai ke mana negeri ini akan berlayar setidaknya dalam kurun lima tahun ke depan. Oleh karena itu data praktikum dibuka untuk dapat digunakan oleh semua kalangan yang tertarik untuk mengulangi praktikum ini.
Alat
Kita menggunakan analisa TF-IDF dan cosine similarity, yang mengungkapkan tingkat kesamaan dan perbedaan masing-masing blok misi.
Selanjutnya, kami menerapkan Latent Dirichlet Allocation (LDA) untuk mengidentifikasi topik-topik utama dalam misi blok-blok tersebut. LDA membantu dalam menggali tema-tema dominan seperti nasionalisme, ekonomi, keadilan, inklusivitas, dan pembangunan ekonomi.
Bahan
Berikut ini data dari KPU yang sudah dikemas dalam bentuk JSON:
{
    "StopWords": ["dan","yang"],

    "Blok": [
        {
            "Nama": "A",
            "Visi": "Indonesia Adil dan Makmur untuk Semua",
            "Misi": [
                "Memastikan ketersediaan kebutuhan pokok dan biaya hidup murah melalui kemandirian pangan, ketahanan energi, dan kedaulatan air",
                "Mengentaskan kemiskinan dengan memperluas kesempatan berusaha dan menciptakan lapangan kerja, mewujudkan upah berkeadilan, menjamin kemajuan ekonomi berbasis kemandirian dan pemerataan, serta mendukung korporasi Indonesia berhasil di negeri sendiri dan bertumbuh di kancah global",
                "Mewujudkan keadilan ekologis berkelanjutan untuk generasi mendatang",
                "Membangun kota dan desa berbasis kawasan yang manusiawi, berkeadilan, dan saling memajukan",
                "Mewujudkan manusia Indonesia yang sehat, cerdas, produktif, berakhlak, serta berbudaya",
                "Mewujudkan keluarga Indonesia yang sejahtera dan bahagia sebagai akar kekuatan bangsa",
                "Memperkuat sistem pertahanan dan keamanan negara, serta meningkatkan peran dan kepemimpinan Indonesia dalam kancah global untuk mewujudkan kepentingan nasional dan perdamaian dunia",
                "Memulihkan kualitas demokrasi, menegakkan hukum dan HAM, memberantas korupsi tanpa tebang pilih, serta menyelenggarakan pemerintahan yang berpihak pada rakyat"
            ]
        },
        {
            "Nama": "B",
            "Visi": "Bersama Indonesia Maju Menuju Indonesia Emas 2045",
            "Misi": [
                "Memantapkan sistem pertahanan keamanan negara dan mendorong kemandirian bangsa melalui swasembada pangan, energi, air, ekonomi syariah, ekonomi digital, ekonomi hijau, dan ekonomi biru",
                "Melanjutkan pengembangan infrastruktur dan meningkatkan lapangan kerja yang berkualitas, mendorong kewirausahaan, mengembangkan industri kreatif serta mengembangkan agro-maritim industri di sentra produksi melalui peran aktif koperasi",
                "Memperkuat pembangunan sumber daya manusia (SDM), sains, teknologi, pendidikan, kesehatan, prestasi olahraga, kesetaraan gender, serta penguatan peran perempuan, pemuda (generasi milenial dan generasi Z), dan penyandang disabilitas",
                "Melanjutkan hilirisasi dan mengembangkan industri berbasis sumber daya alam untuk meningkatkan nilai tambah di dalam negeri",
                "Membangun dari desa dan dari bawah untuk pertumbuhan ekonomi, pemerataan ekonomi, dan pemberantasan kemiskinan",
                "Memperkuat reformasi politik, hukum, dan birokrasi, serta memperkuat pencegahan dan pemberantasan korupsi, narkoba, judi, dan penyelundupan",
                "Memperkuat penyelarasan kehidupan yang harmonis dengan lingkungan, alam dan budaya, serta peningkatan toleransi antarumat beragama untuk mencapai masyarakat yang adil dan makmur"
            ]
        },
        {
            "Nama": "C",
            "Visi": "Gerak Cepat Menuju Indonesia Unggul",
            "Misi": [
                "Manusia Indonesia yang sehat, terdidik, dan sejahtera",
                "Indonesia unggul dalam bidang inovasi dan teknologi",
                "Ekonomi yang tangguh dan berdikari",
                "Hilangnya kemiskinan dan ketimpangan antarwilayah dari akarnya",
                "Ekosistem digital yang mengutamakan akses internet cepat dan terjangkau",
                "Pembangunan ekonomi yang memperhatikan kelestarian lingkungan",
                "Demokrasi terjaga melalui pemberantasan korupsi dan pemerintahan inklusif berlandaskan supremasi hukum",
                "Indonesia bangsa terhormat di kancah internasional, serta pertahanan yang tangguh dan modern"
            ]
        }
    ]
}
Pemetaan Topik
Grafik di bawah ini adalah grafik heatmap yang menggambarkan hasil analisis TF-IDF (Term Frequency-Inverse Document Frequency) untuk ketiga blok teks. Heatmap ini menunjukkan frekuensi relatif dari berbagai istilah di setiap blok teks.
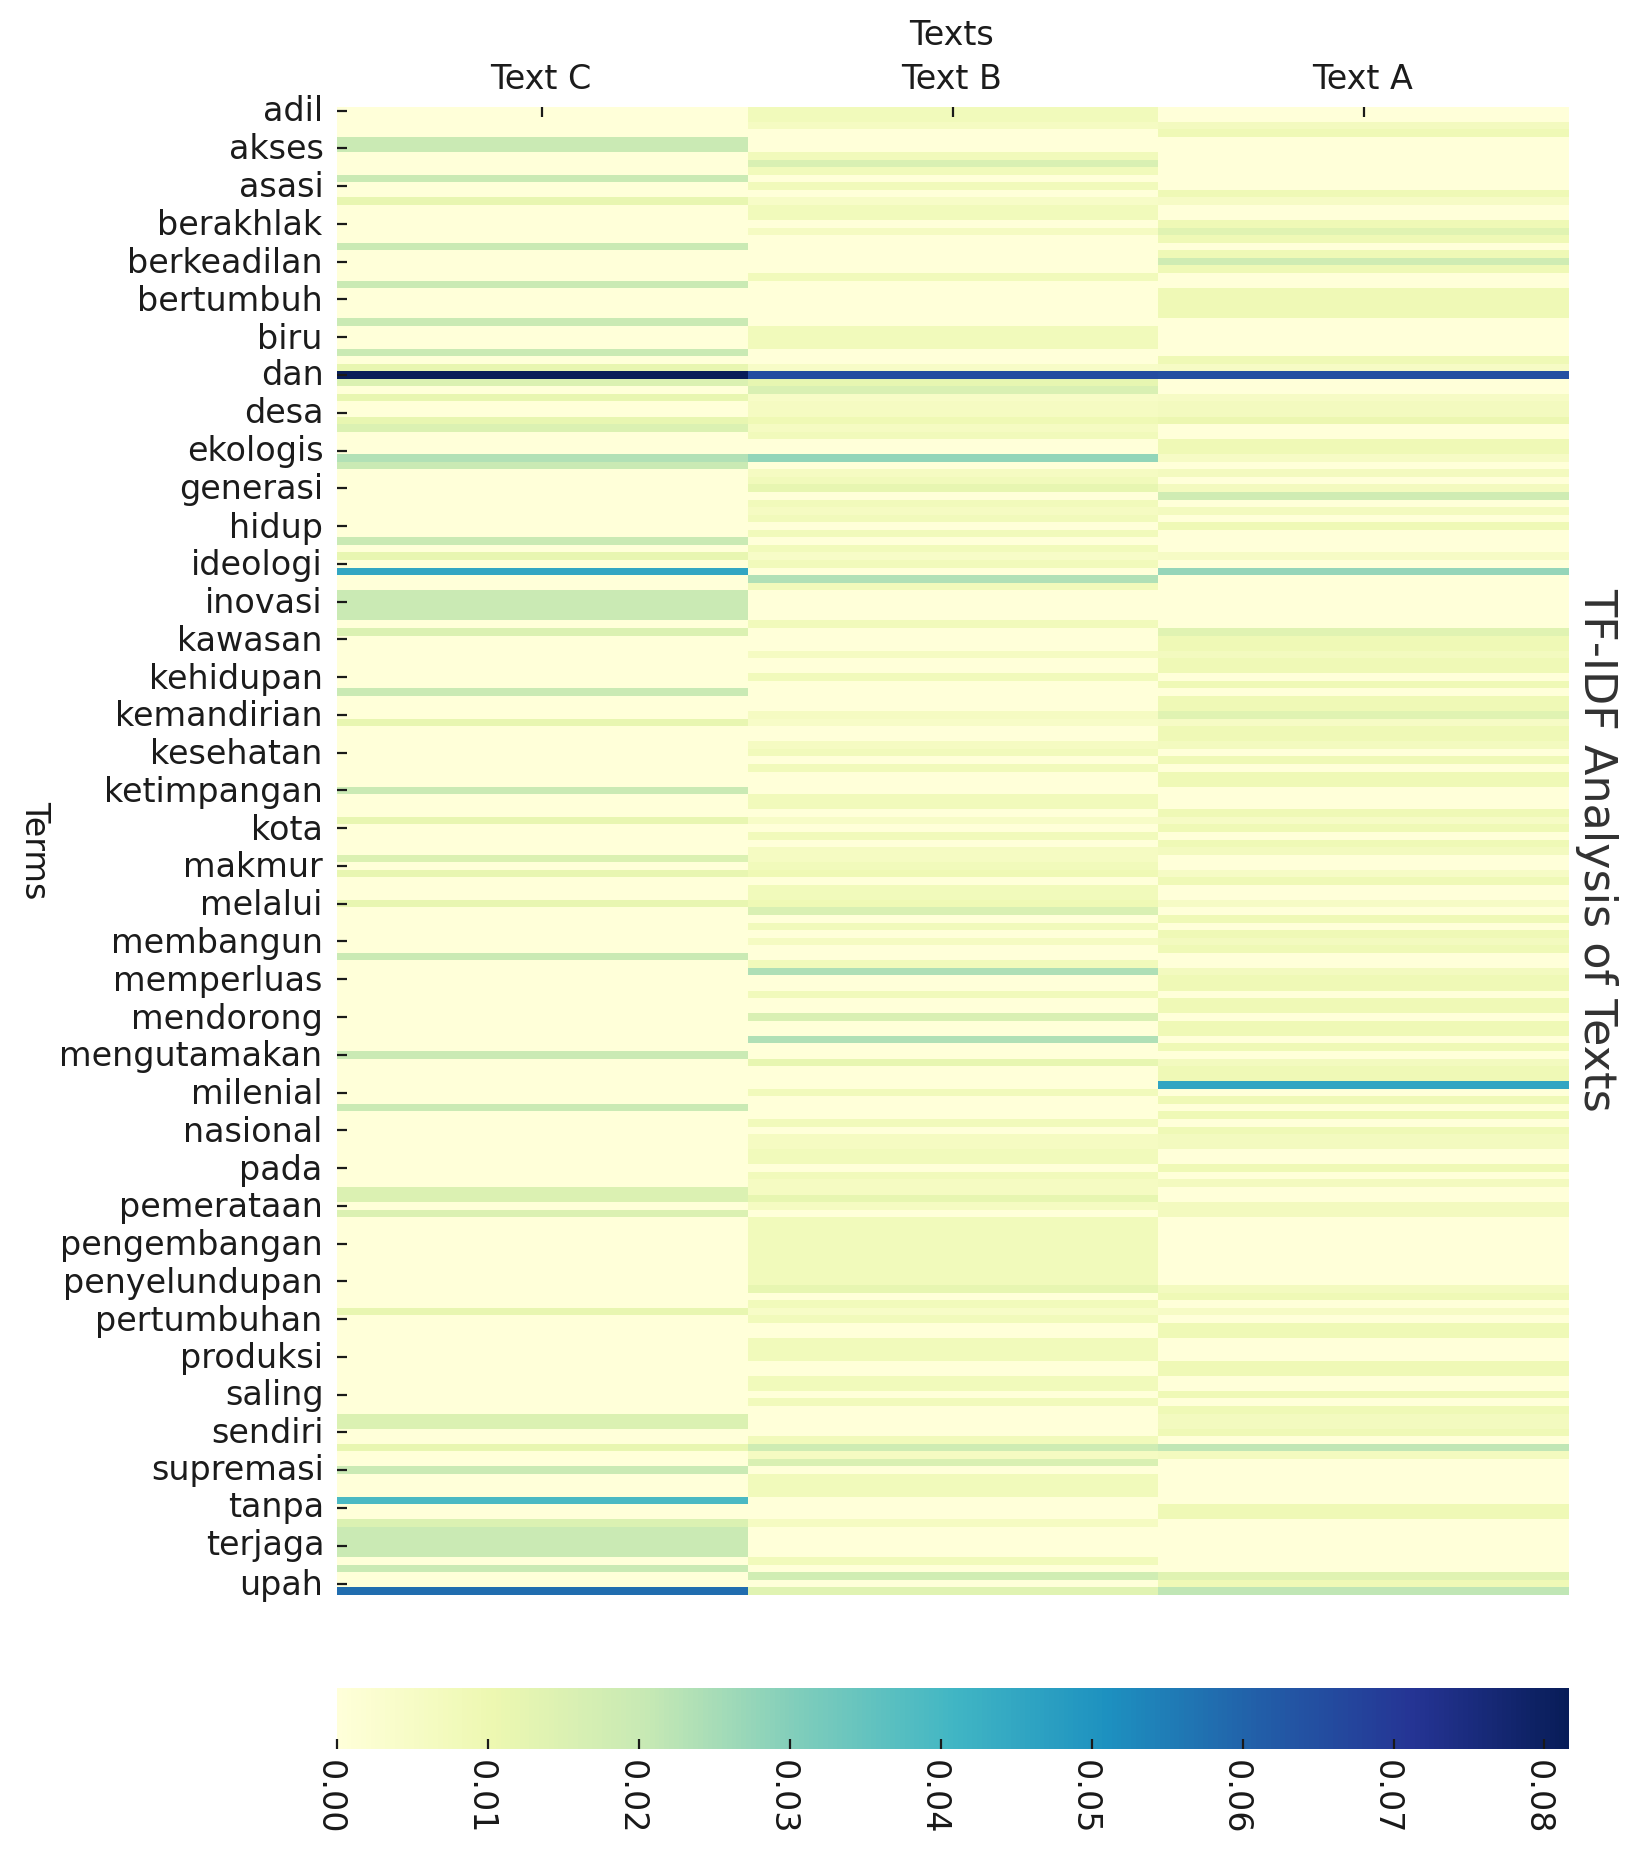
- Sumbu vertikal menampilkan ketiga blok teks: Blok A, Blok B, dan Blok C.
- Sumbu horizontal menampilkan istilah-istilah yang dianalisis dalam teks.
- Warna pada heatmap mencerminkan frekuensi relatif istilah tersebut dalam teks: semakin gelap warnanya, semakin tinggi frekuensinya relatif terhadap istilah lain dalam teks yang sama.
Grafik ini membantu dalam memvisualisasikan perbedaan dan kesamaan dalam penggunaan istilah di antara ketiga blok teks, memberikan wawasan visual mengenai fokus topik atau penekanan kata kunci dalam setiap blok.
Kesamaan dan Perbedaan
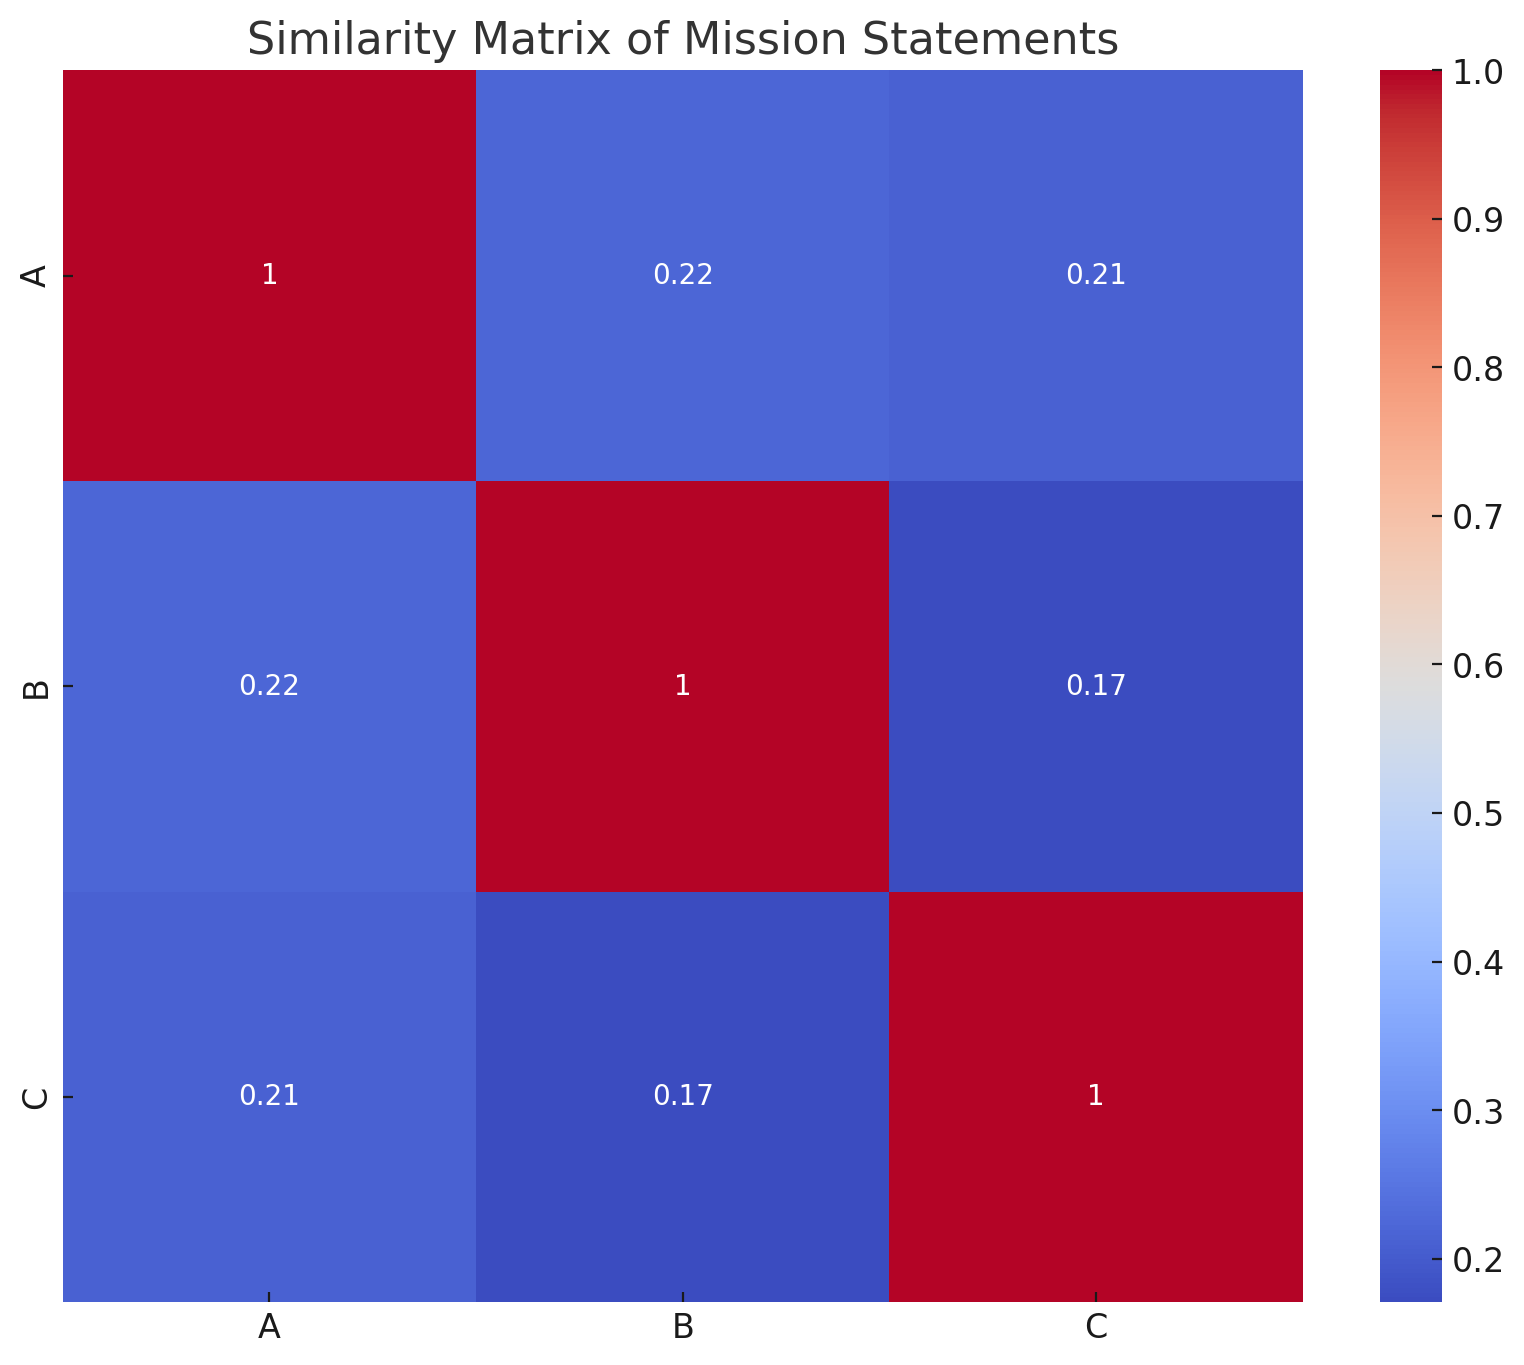
Analisis tentang kesamaan antara pernyataan misi ("Misi") dari setiap blok telah menghasilkan hasil sebagai berikut:
kode Python dan hasil eksekusi
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

# Mengekstrak pernyataan misi dan nama-nama blok
missions = {block['Nama']: ' '.join(block['Misi']) for block in data['Blok']}
block_names = list(missions.keys())
mission_texts = list(missions.values())

# Menghapus kata-kata penghenti (stopwords)
stopwords = data['StopWords']
vectorizer = TfidfVectorizer(stop_words=stopwords)

# Vektorisasi pernyataan misi
tfidf_matrix = vectorizer.fit_transform(mission_texts)

# Menghitung kesamaan kosinus
cosine_sim = cosine_similarity(tfidf_matrix)

# Membuat DataFrame untuk visualisasi yang lebih baik
similarity_df = pd.DataFrame(cosine_sim, index=block_names, columns=block_names)

# Menemukan blok yang paling mirip dan paling tidak mirip
most_similar_blocks = similarity_df.unstack().sort_values(ascending=False)
most_similar_blocks = most_similar_blocks[most_similar_blocks != 1]  # Menyingkirkan perbandingan dengan diri sendiri
most_similar_pair = most_similar_blocks.idxmax()
least_similar_pair = most_similar_blocks.idxmin()

# Membuat plot matriks kesamaan
plt.figure(figsize=(10, 8))
sns.heatmap(similarity_df, annot=True, cmap='coolwarm')
plt.title("Matriks Kesamaan Pernyataan Misi")
plt.show()

most_similar_pair, least_similar_pair, similarity_df
Hasil eksekusi:
(('A', 'A'),
 ('B', 'C'),
           A         B         C
 A  1.000000  0.221696  0.209756
 B  0.221696  1.000000  0.170655
 C  0.209756  0.170655  1.000000)
- Matriks Kesamaan: Blok A dan Blok A (perbandingan terhadap diri-sendiri) memiliki skor kesamaan 1,00. Ini adalah hasil yang diharapkan. Skor kesamaan antara blok lain adalah sebagai berikut:
- Blok A dan Blok B: 0,22
- Blok A dan Blok C: 0,21
- Blok B dan Blok C:
0,17
- Pasangan Paling Serupa dan Paling Tidak Serupa:
- Pasangan paling serupa adalah
Blok AdanBlok A, berdasarkan "perbandingan diri" (self-comparison). - Mengesampingkan "perbandingan diri", pasangan paling serupa adalah Blok A dan Blok B.
- Pasangan paling tidak serupa adalah Blok B dan Blok C.
Sebelum melangkah lebih jauh, baiklah terlebih dulu dijelaskan apa yang dimaksud dengan metode "self-comparison" dalam Sains Data.
Bayangkan Anda menatap cermin. Saat menatap cermin, ada bayangan dirimu sendiri bukan pokemon atau genderuwo kan? Jika seseorang bertanya, "Apakah bayangan pada cermin itu mirip dengan kamu?" jawabannya tentu "Ya, sangat mirip," karena memang itu adalah bayanganmu sendiri. Ini contoh sederhana bagaimana "self-comparison" atau membandingkan sesuatu dengan dirinya sendiri.
Metode "self-comparison" seperti melihat cermin. Kita membandingkan teks atau data blok dengan teks atau data blok yang sama. Jadi, sama seperti melihat cermin, hasilnya pasti akan sangat mirip, karena sebenarnya itu adalah hal yang sama.
Dalam analisis data atau teks, melakukan "self-comparison" adalah seperti memeriksa apakah cermin (persamaan matematika persisnya) bekerja dengan benar. Jika melihat cermin dan melihat gambaran yang sama dengan dirimu, maka cermin itu bekerja dengan benar. Begitu juga dalam analisis data, jika kita membandingkan data dengan dirinya sendiri dan hasilnya sangat mirip, itu berarti metode yang kita gunakan untuk membandingkan bekerja sesuai harapan.
Camkan selalu: cermin tidak memberi informasi baru tentang dunia sekitar kita, "self-comparison" dalam analisis data juga tidak memberikan wawasan baru tentang perbedaan atau kesamaan antara blok politik yang berbeda. Itu hanya memastikan bahwa perkakas matematis yang kita gunakan berfungsi sebagaimana mestinya.
Analisis Sentimen
Tahap ini akan mencari arah sentimen (positif, negatif, atau netral) dan skor sentimen untuk setiap pernyataan misi. Kemudian, kita akan membandingkan sentimen masing-masig blok data di atas.
kode Python dan hasil eksekusi
from textblob import TextBlob

# Fungsi untuk menghitung sentimen
def calculate_sentiment(text):
    analysis = TextBlob(text)
    return analysis.sentiment.polarity

# Menghitung sentimen untuk misi setiap blok
sentiments = {block: calculate_sentiment(missions[block]) for block in block_names}

# Membuat DataFrame untuk visualisasi
sentiment_df = pd.DataFrame(list(sentiments.items()), columns=['Block', 'Sentiment Score'])

# Membuat plot skor sentimen
plt.figure(figsize=(10, 6))
sns.barplot(x='Block', y='Sentiment Score', data=sentiment_df)
plt.title('Analisis Sentimen Pernyataan Misi')
plt.show()

sentiment_df
Hasil eksekusi
  Block  Sentiment Score
0     A              0.0
1     B              0.0
2     C              0.1
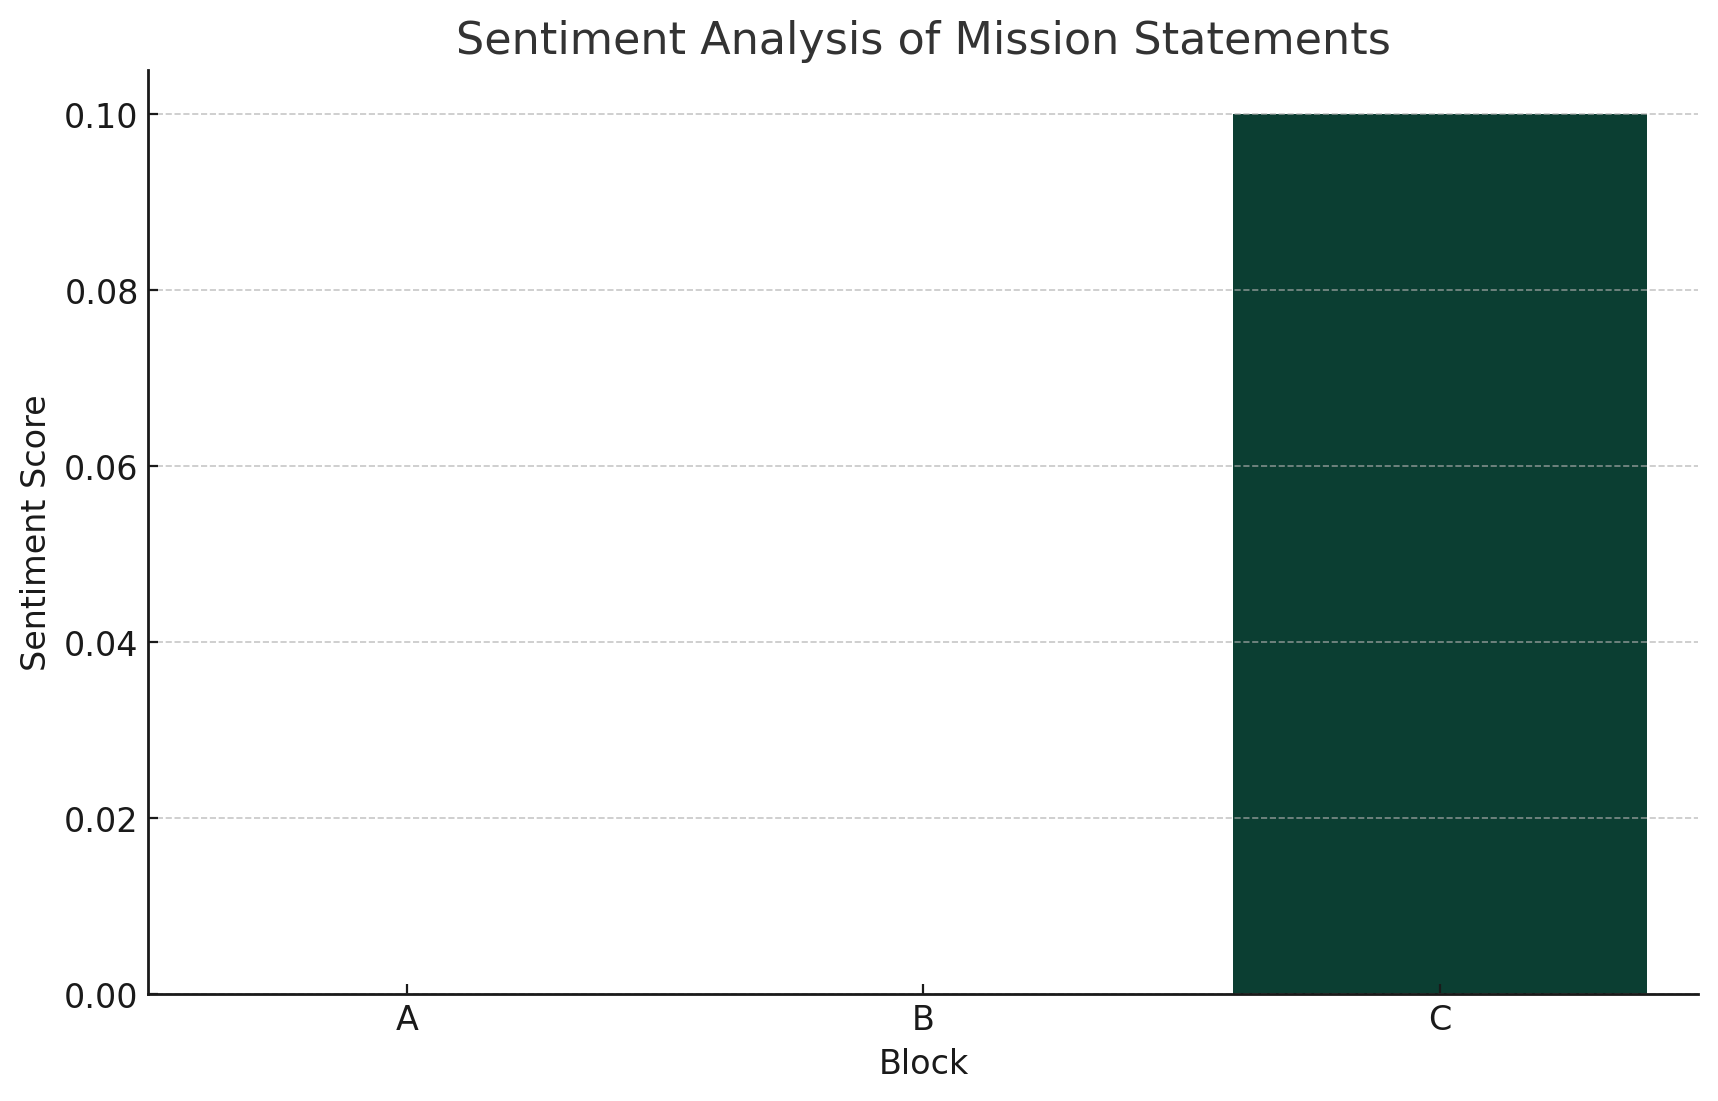
Analisis sentimen daftar misi ("Misi") masing-masing blok mengungkapkan skor sentimen sebagai berikut:
- Blok A: Skor Sentimen = 0.0
- Blok B: Skor Sentimen = 0.0
- Blok C: Skor Sentimen = `0.1`
Skor ini menunjukkan sentimen yang netral hingga sedikit positif dalam pernyataan misi. Blok C menunjukkan sentimen positif lebih tinggi dibanding Blok A dan B, yang keduanya memiliki skor sentimen netral.
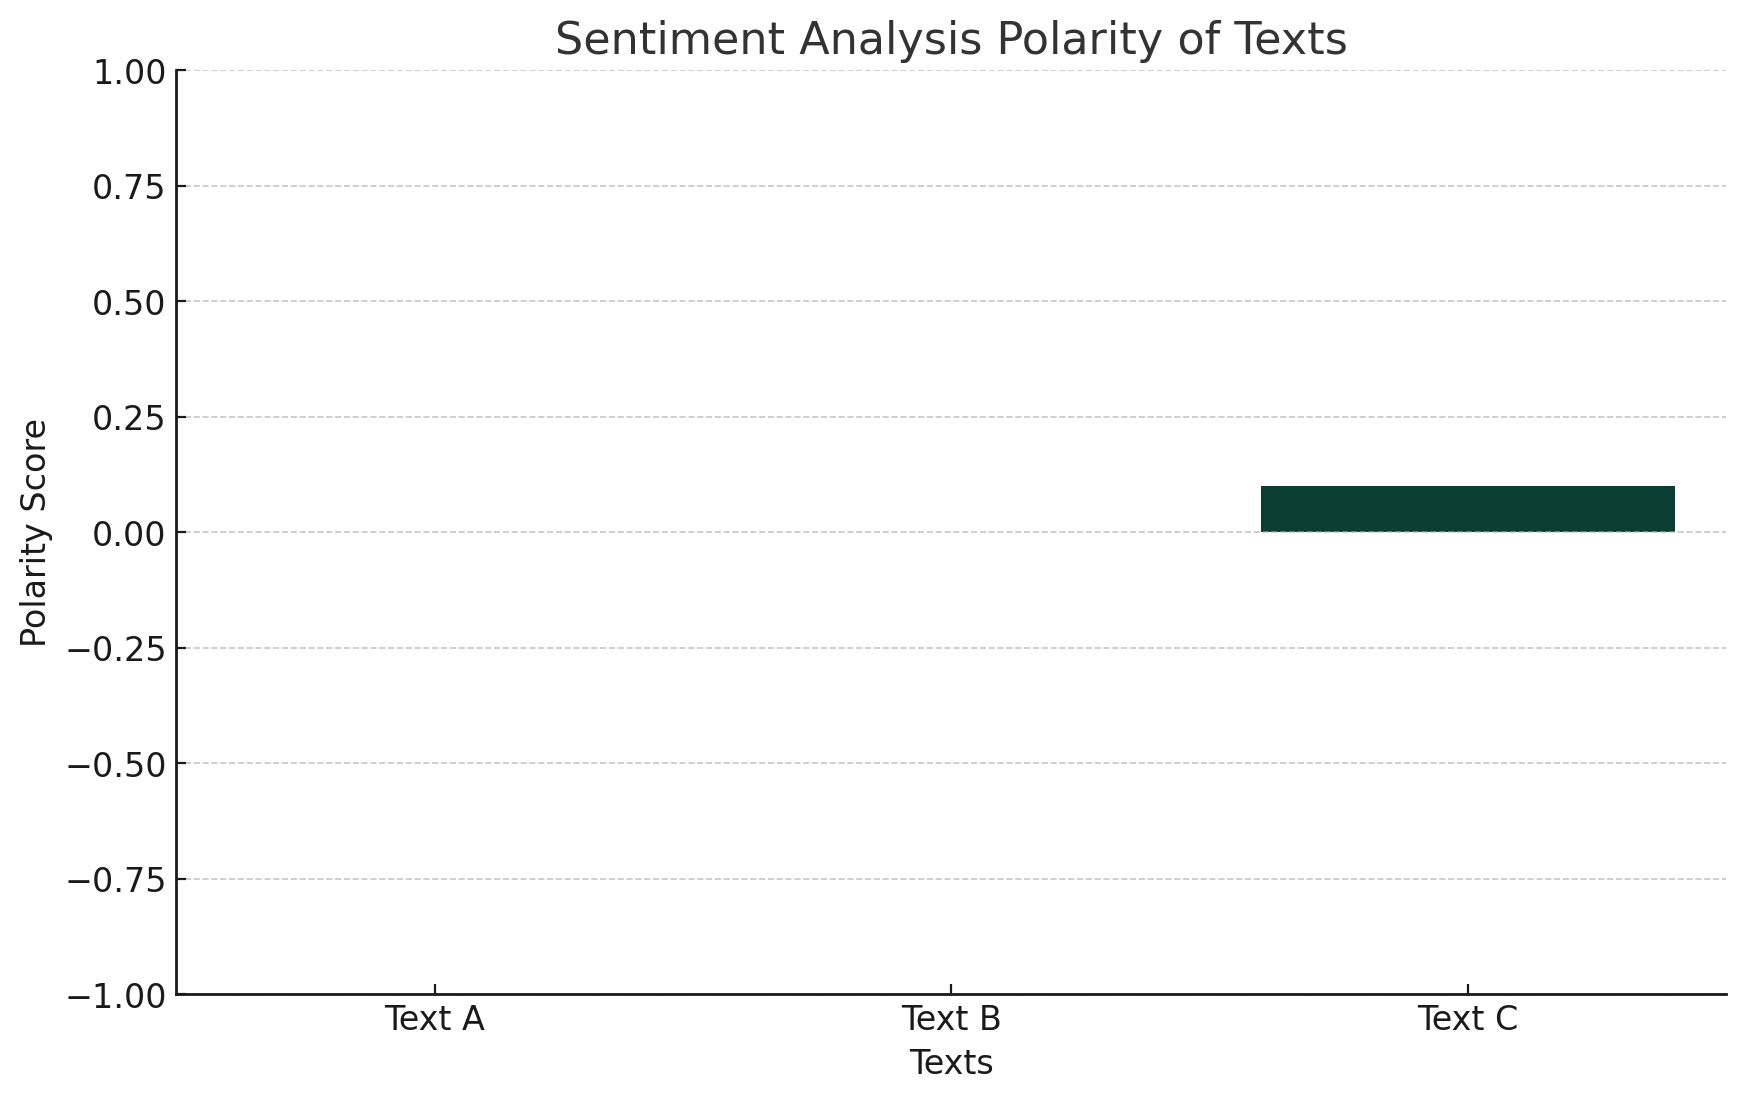
Grafik di atas menampilkan hasil analisis sentimen, khususnya skor polaritas, untuk ketiga blok teks. Polaritas dalam analisis sentimen berkisar dari -1 (sangat negatif) hingga +1 (sangat positif), dan skor yang lebih tinggi menunjukkan sentimen yang lebih positif:
- Sumbu vertikal menunjukkan skor polaritas.
- Sumbu horizontal menampilkan ketiga blok teks: Blok A, Blok B, dan Blok C.
Silakan buka diskusi untuk memperdebatkan tafsir atas perbedaan ini kecil tetapi sangat mencolok.
Analisis Klaster
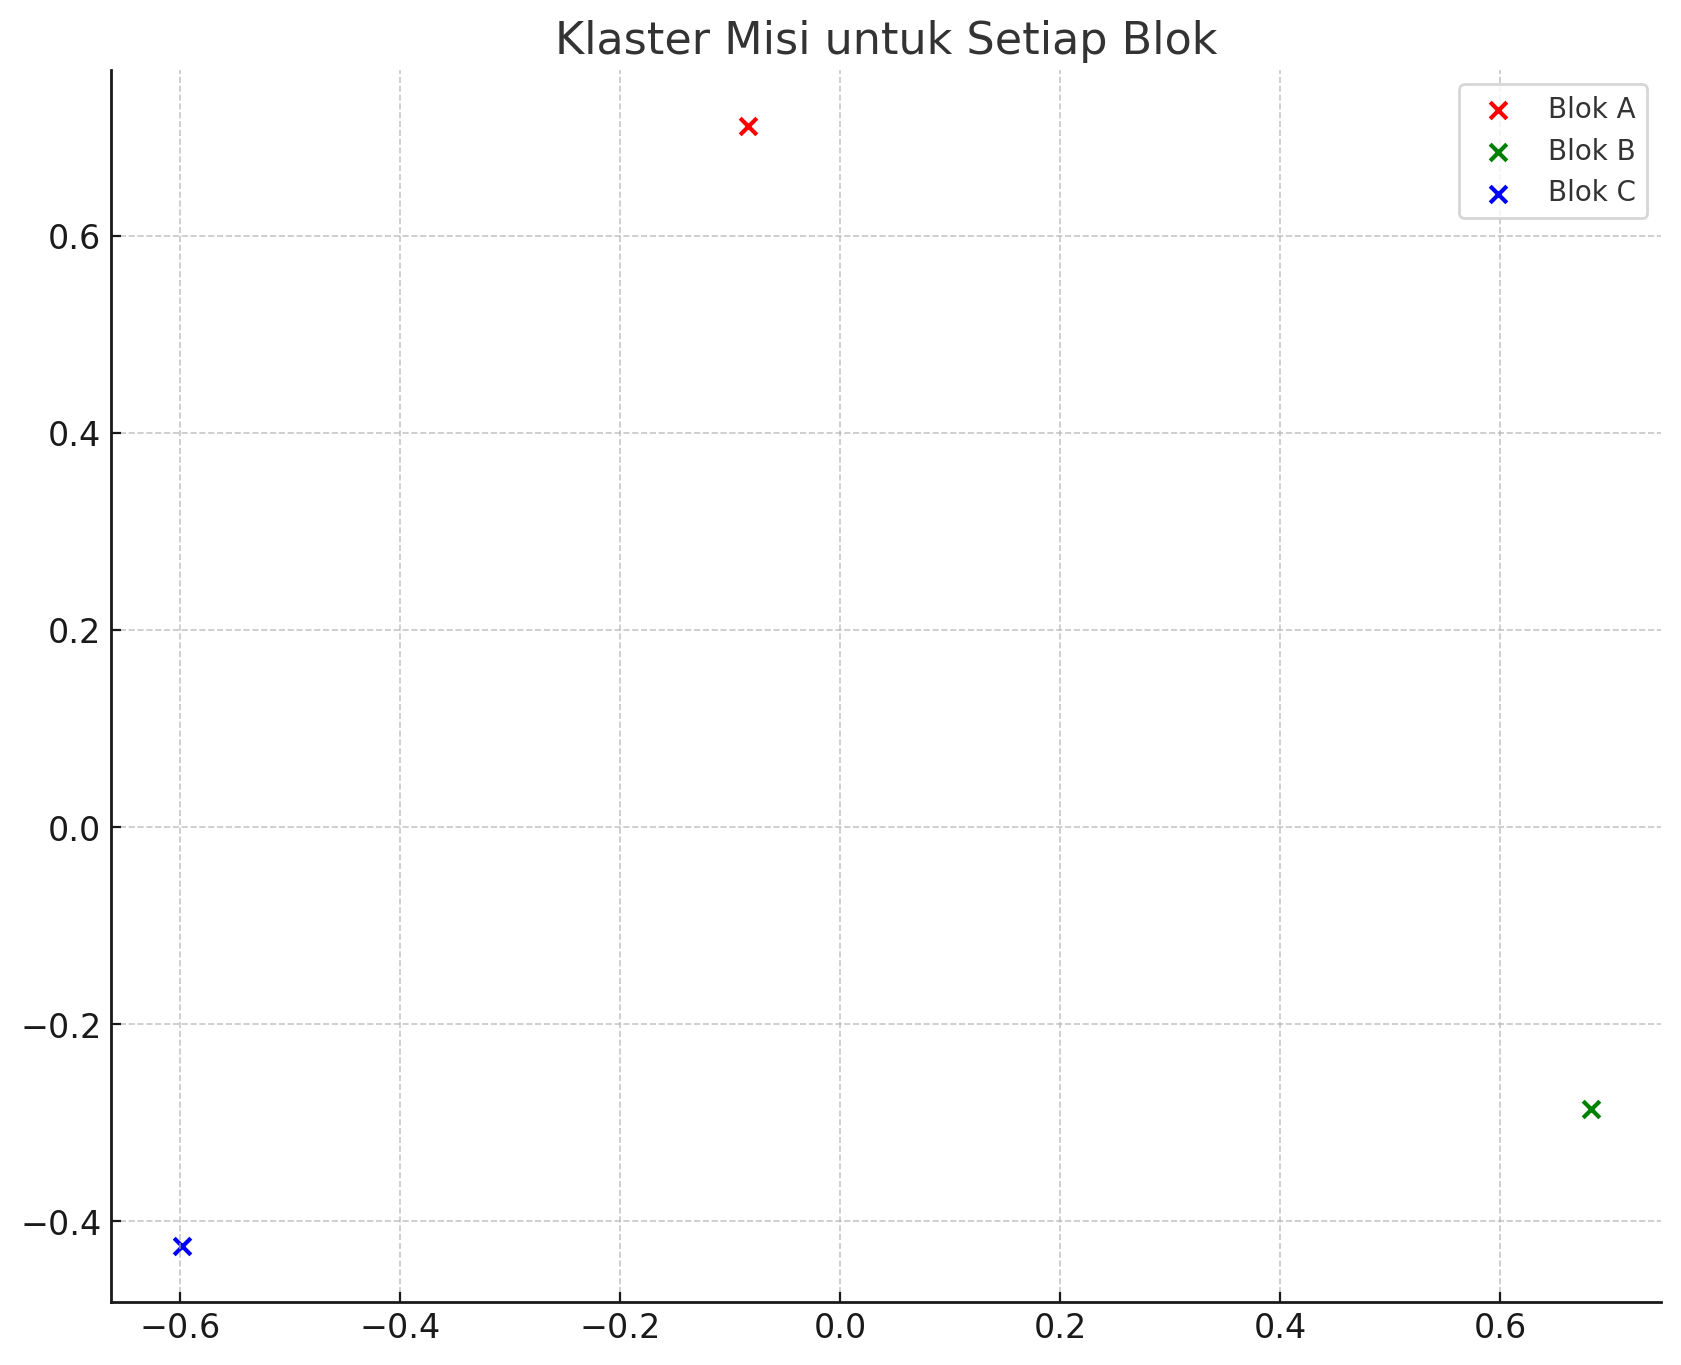
Tahap ini akan memetakan blok mana saja yang berdekatan.
kode Python dan hasil eksekusi
from sklearn.cluster import KMeans
import numpy as np

# Kita akan menggunakan data yang divectorize menggunakan TF-IDF untuk clustering
# Jumlah cluster diatur sesuai dengan jumlah blok untuk pemisahan yang jelas
n_clusters = len(block_names)
kmeans = KMeans(n_clusters=n_clusters, random_state=0)

# Melakukan fitting model
kmeans.fit(tfidf_matrix)

# Mendapatkan label cluster
clusters = kmeans.labels_

# Membuat PCA 2D untuk memplot cluster
from sklearn.decomposition import PCA

pca = PCA(n_components=2)
reduced_features = pca.fit_transform(tfidf_matrix.toarray())

# Memplot cluster
plt.figure(figsize=(10, 8))
colors = ['r', 'g', 'b']
for i, color in zip(range(n_clusters), colors):
    plt.scatter(reduced_features[clusters == i, 0], reduced_features[clusters == i, 1], color=color, label=f'Blok {block_names[i]}')
plt.title("Klaster Misi untuk Setiap Blok")
plt.legend()
plt.show()

# Membuat DataFrame untuk menunjukkan blok mana yang termasuk dalam cluster mana
cluster_df = pd.DataFrame({'Block': block_names, 'Cluster': clusters})
cluster_df
Hasil eksekusi:
  Block  Cluster
0     A        0
1     B        2
2     C        1
Analisis klaster memetakan:
- Blok A masuk Klaster 0.
- Blok B masuk Klaster 2.
- Blok C masuk Klaster 1.
Dalam grafik di atas, kita menggunakan metode PCA (Principal Component Analysis) untuk mereduksi data ke ruang dua dimensi, sehingga memudahkan visualisasi. Setiap titik mewakili misi per satu blok, dan warna berbeda mewakili klaster yang berbeda. Dari grafik ini, kita dapat melihat distribusi spasial (jarak) blok-blok tersebut berdasarkan konten misi mereka.
Aturan tafsir visualisasi itu adalah sbb:
- Blok berdekatan menunjukkan bahwa kesamaan yang lebih banyak dalam hal konten misi.
- Blok berjauhan menunjukkan perbedaan yang lebih besar dalam konten misi mereka.
Berdasarkan visualisasi ini, kita dapat menginterpretasikan bahwa:
- Blok A dan Blok C mungkin memiliki beberapa kesamaan dalam konten misi mereka, karena mereka lebih dekat dalam ruang klaster.
- Blok B terpisah lebih jauh dari kedua blok lainnya, menunjukkan perbedaan yang lebih besar dalam konten misi dibandingkan dengan Blok A dan C.
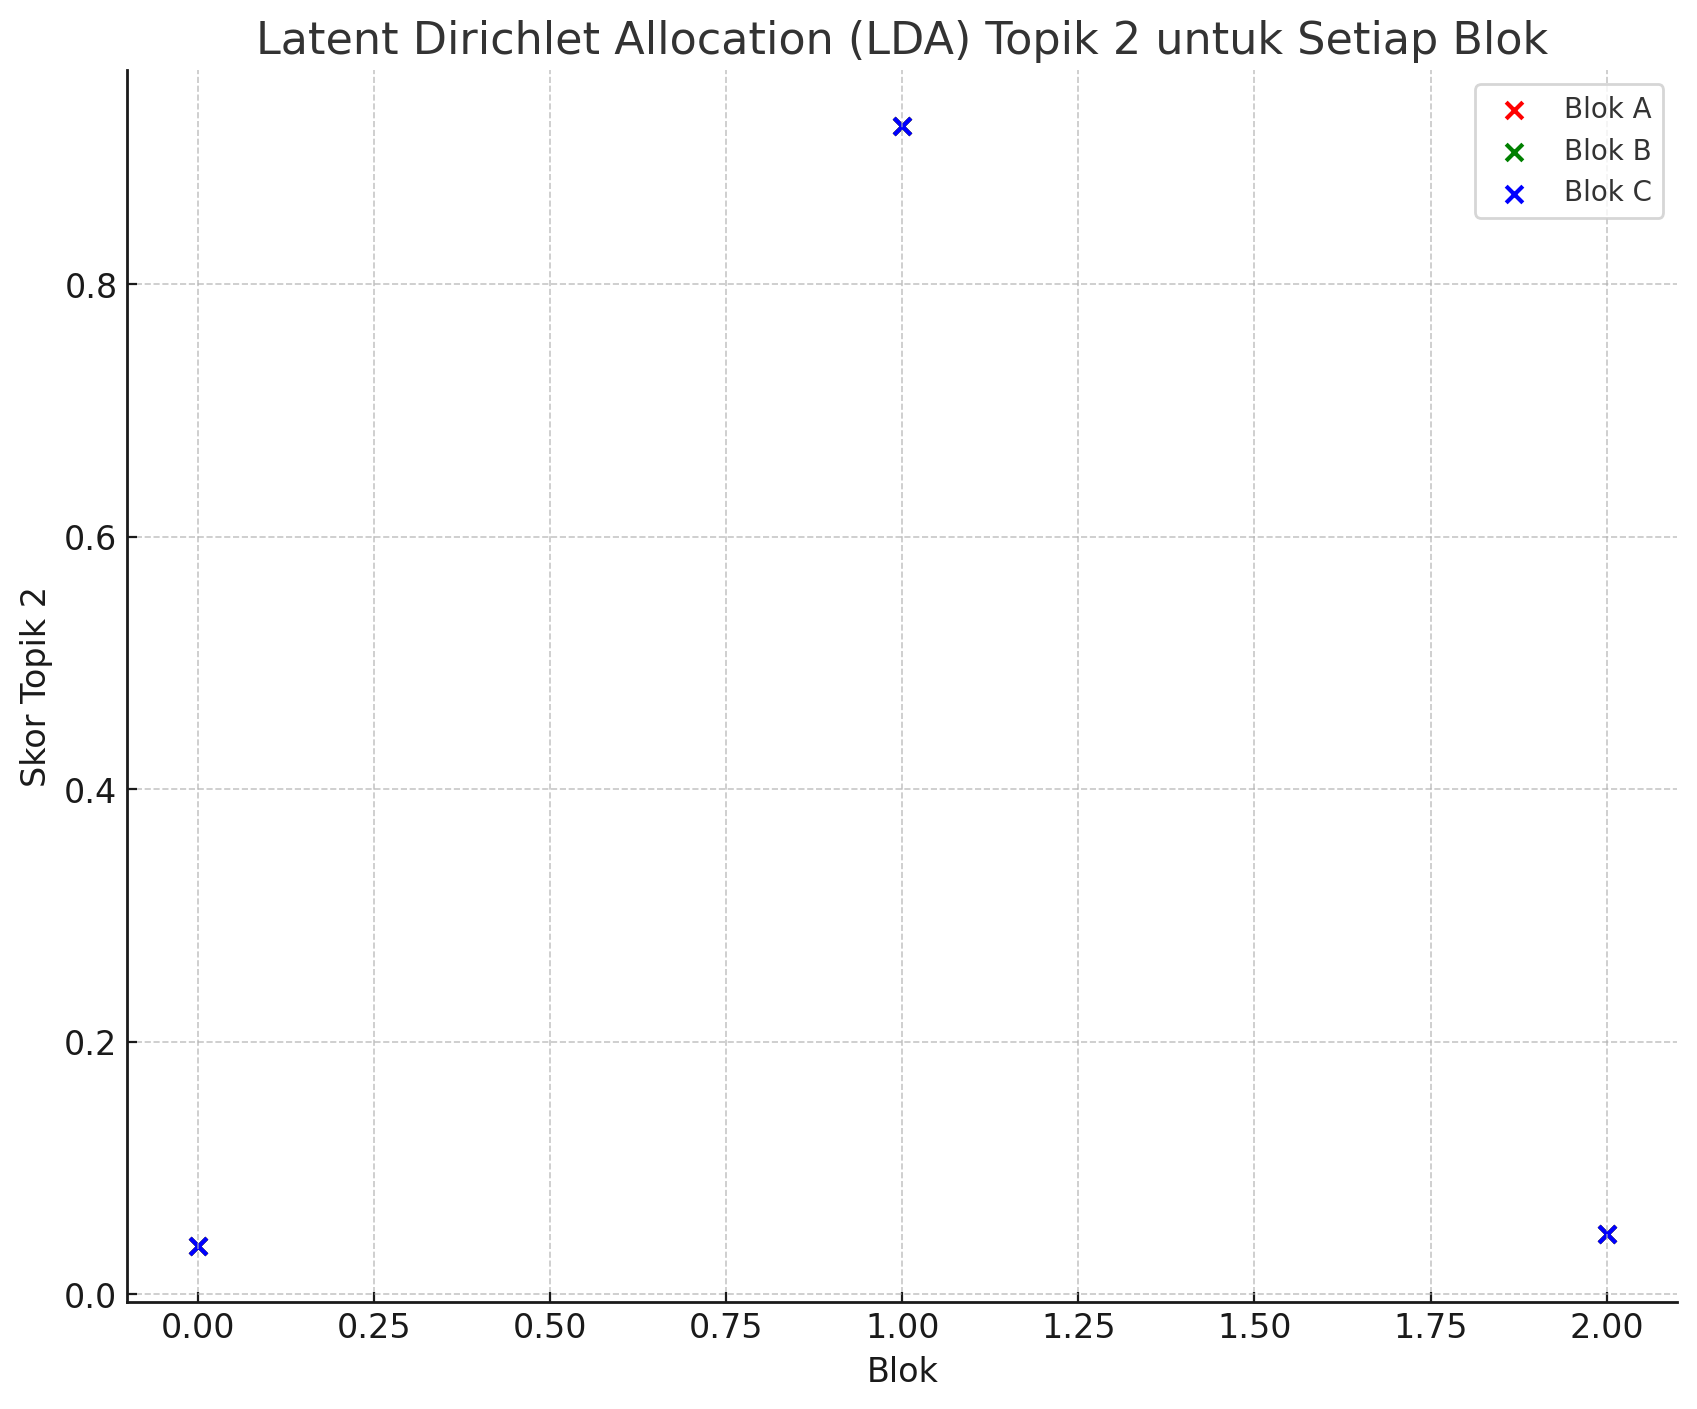
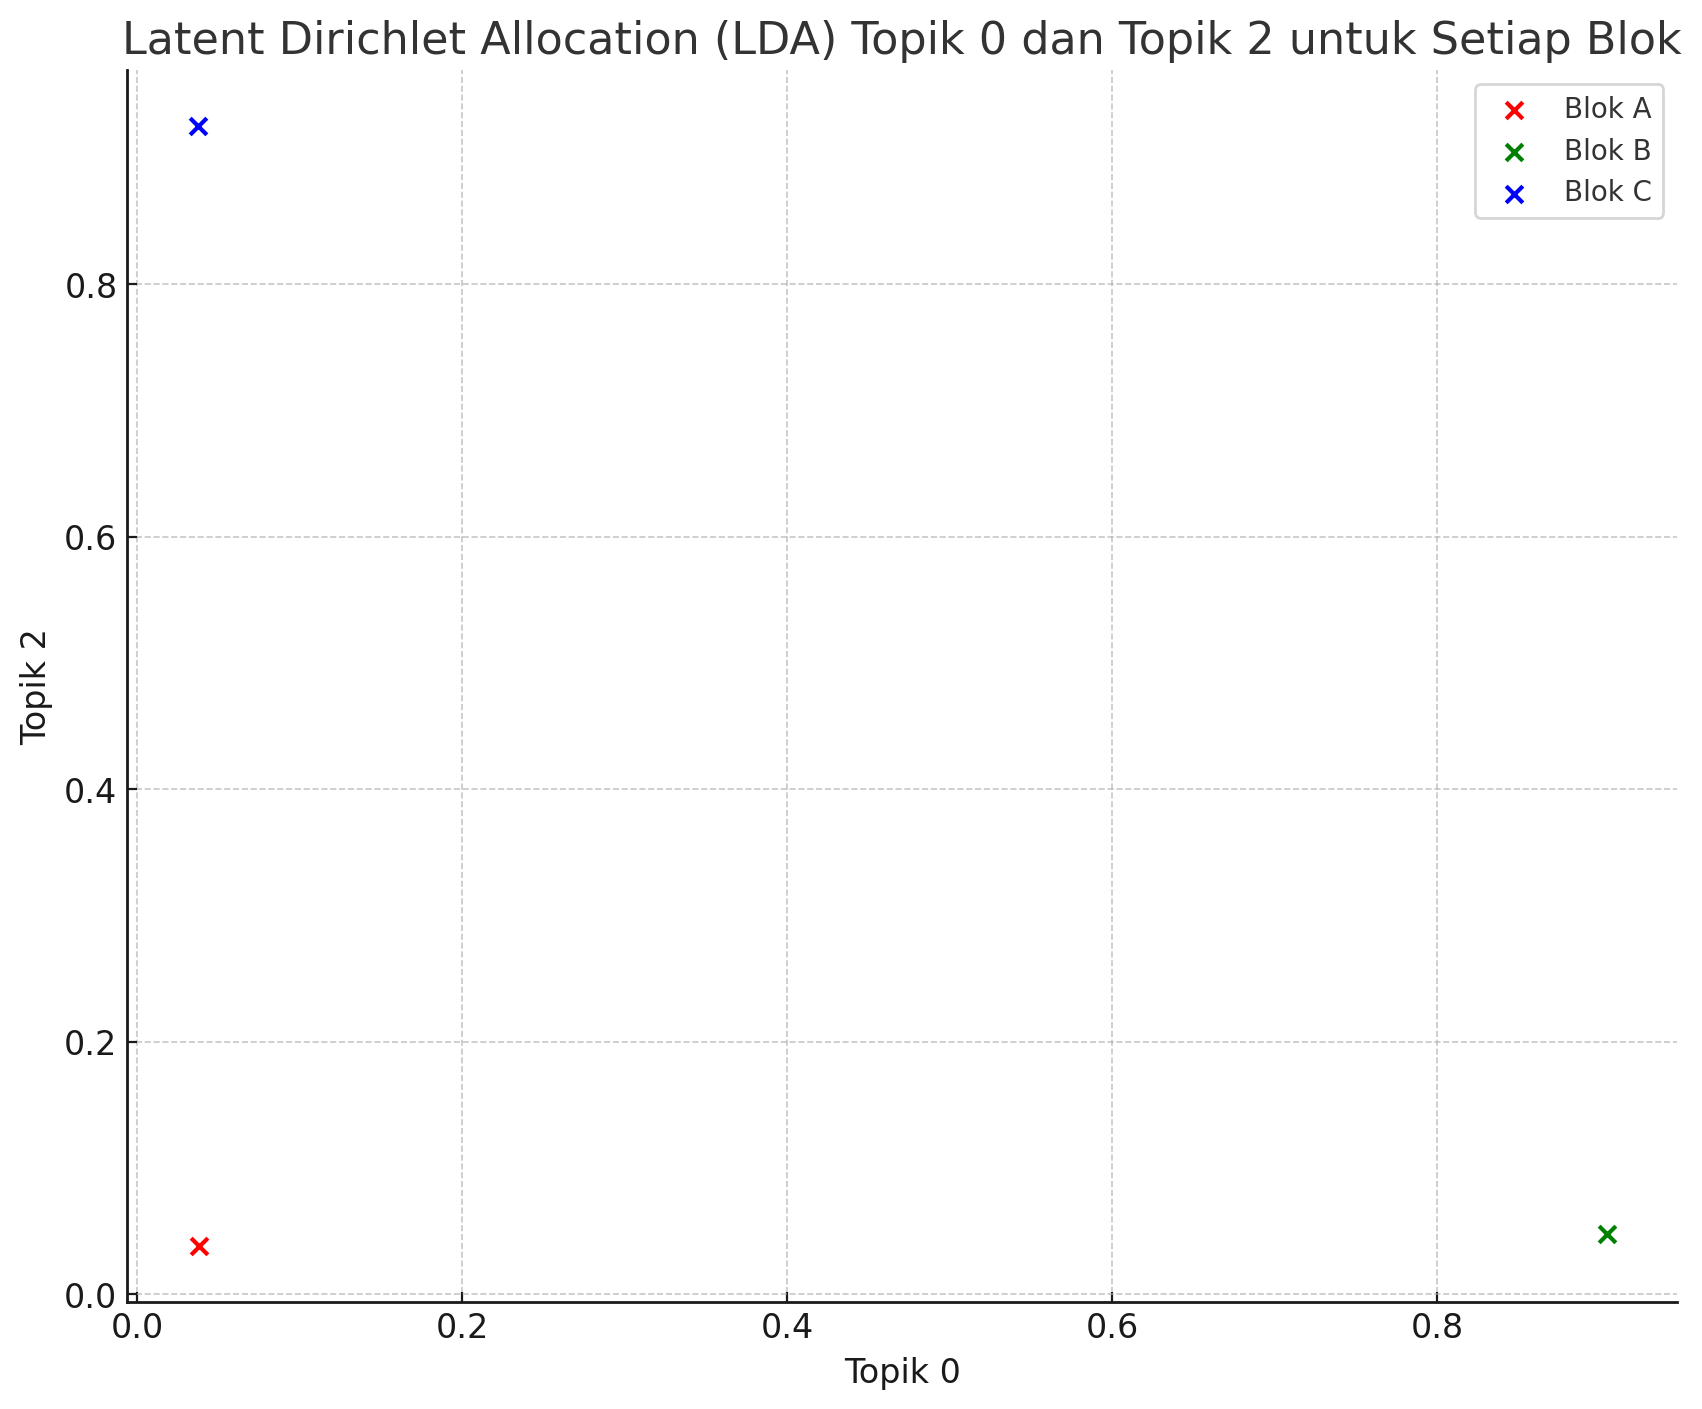
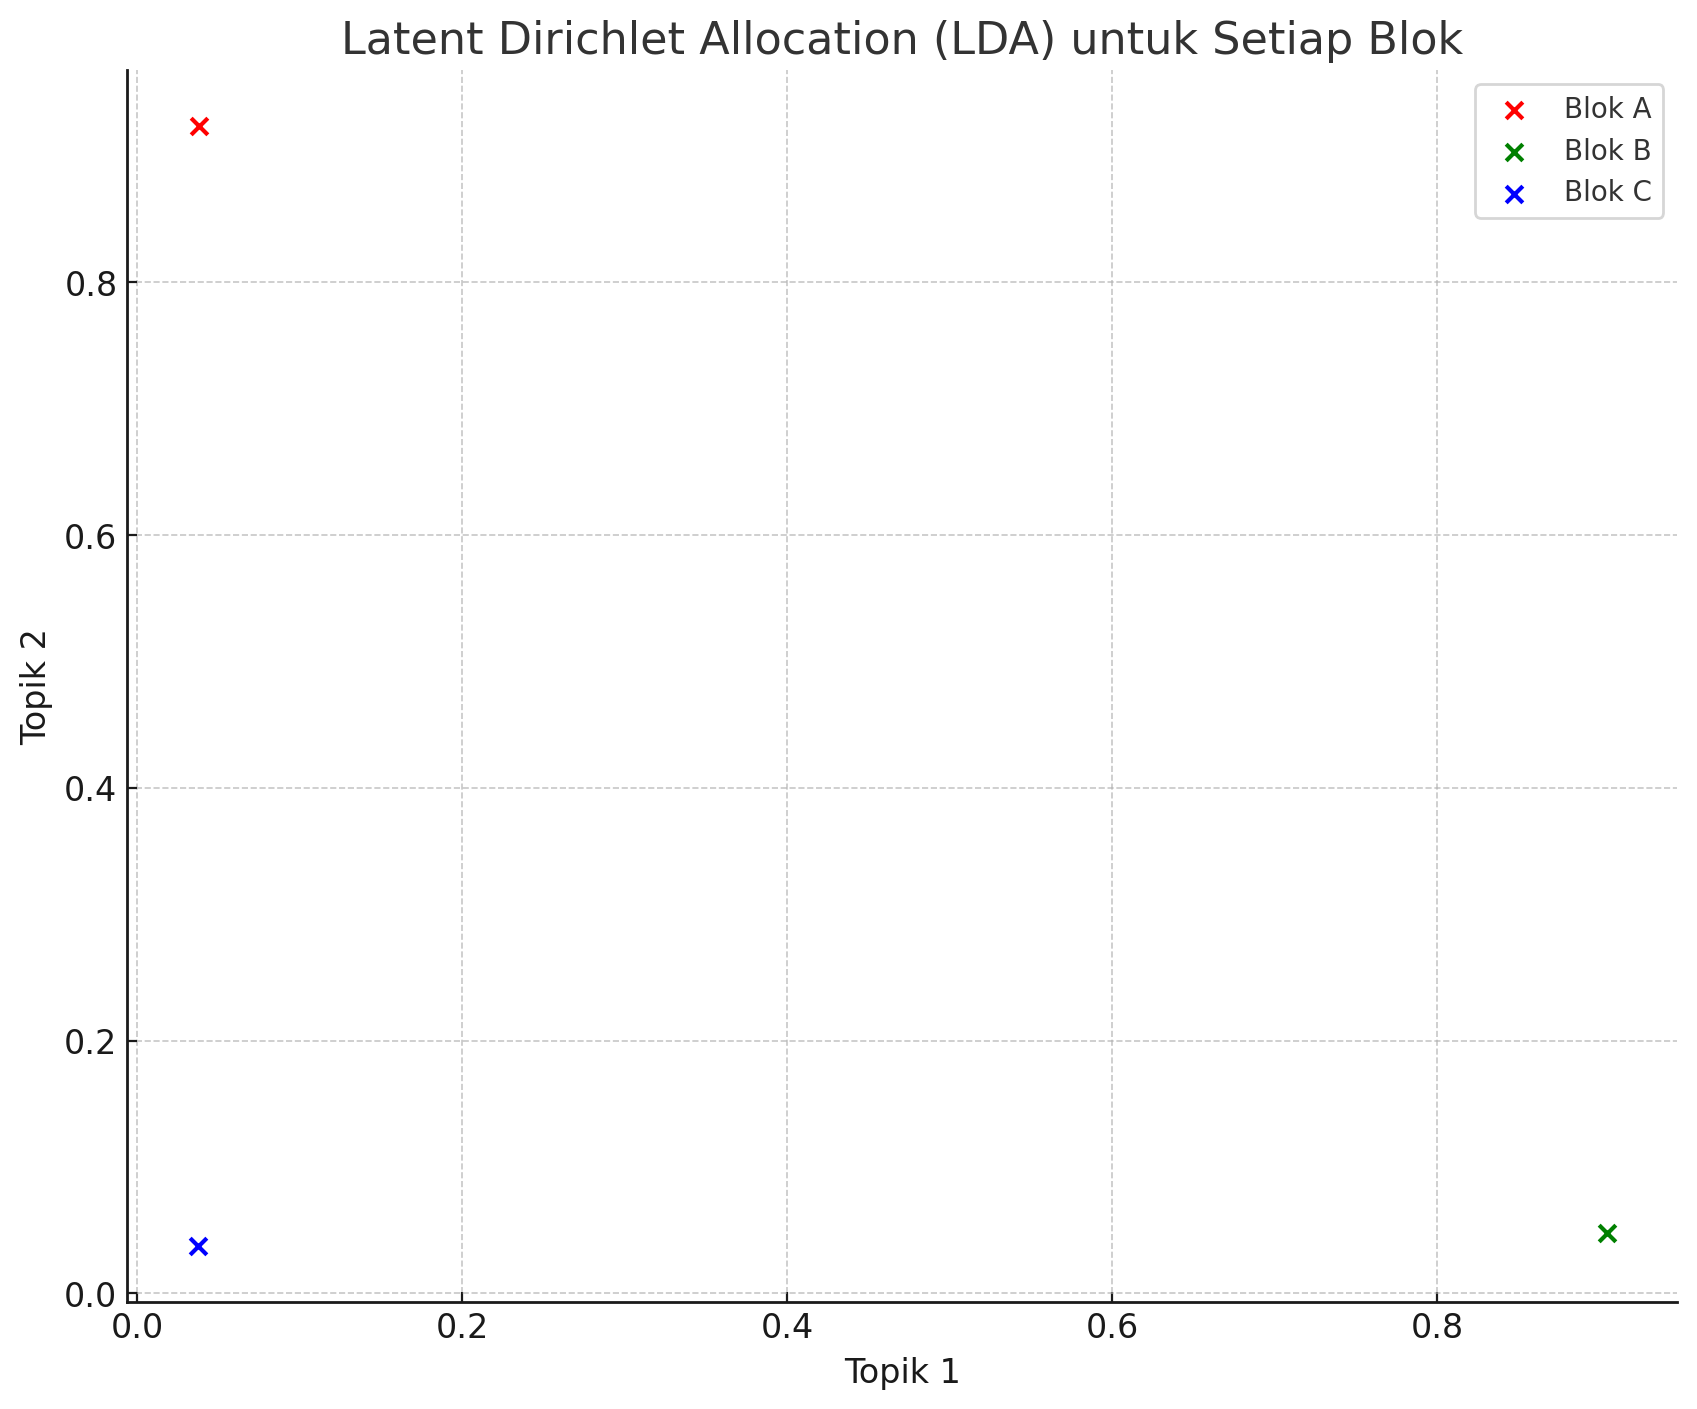
Analisis metode Latent Dirichlet Allocation (LDA) menghasilkan visualisasi dan pemahaman tentang topik-topik yang dominan dalam misi masing-masing blok.
- Setiap titik mewakili misi dari satu blok, dengan warna yang berbeda untuk setiap blok.
- Posisi titik-titik pada grafik menunjukkan keterkaitan misi blok tersebut dengan topik tertentu yang diidentifikasi oleh LDA.
Dari grafik LDA, kita dapat melihat bagaimana masing-masing blok berhubungan dengan dua topik utama yang dihasilkan oleh model. Topik ini diwakili oleh sumbu x dan y pada grafik. Kedekatan blok ke salah satu sumbu menunjukkan keterkaitan yang lebih kuat dengan topik yang bersangkutan.
Selain itu, tabel yang dihasilkan menunjukkan kata-kata kunci untuk setiap topik:
- Topik 0: Terkait dengan kata-kata seperti "Indonesia", "tangguh", dan "ekonomi", yang mungkin mencerminkan fokus pada kekuatan nasional dan ekonomi.
- Topik 1: Meliputi kata-kata seperti "mewujudkan", "Indonesia", dan "global", yang menunjukkan tema pembangunan inklusif dan kepemimpinan global.
- Topik 2: Termasuk kata-kata seperti "ekonomi", "memperkuat", dan "mengembangkan", menunjukkan fokus pada penguatan ekonomi dan pengembangan industri.
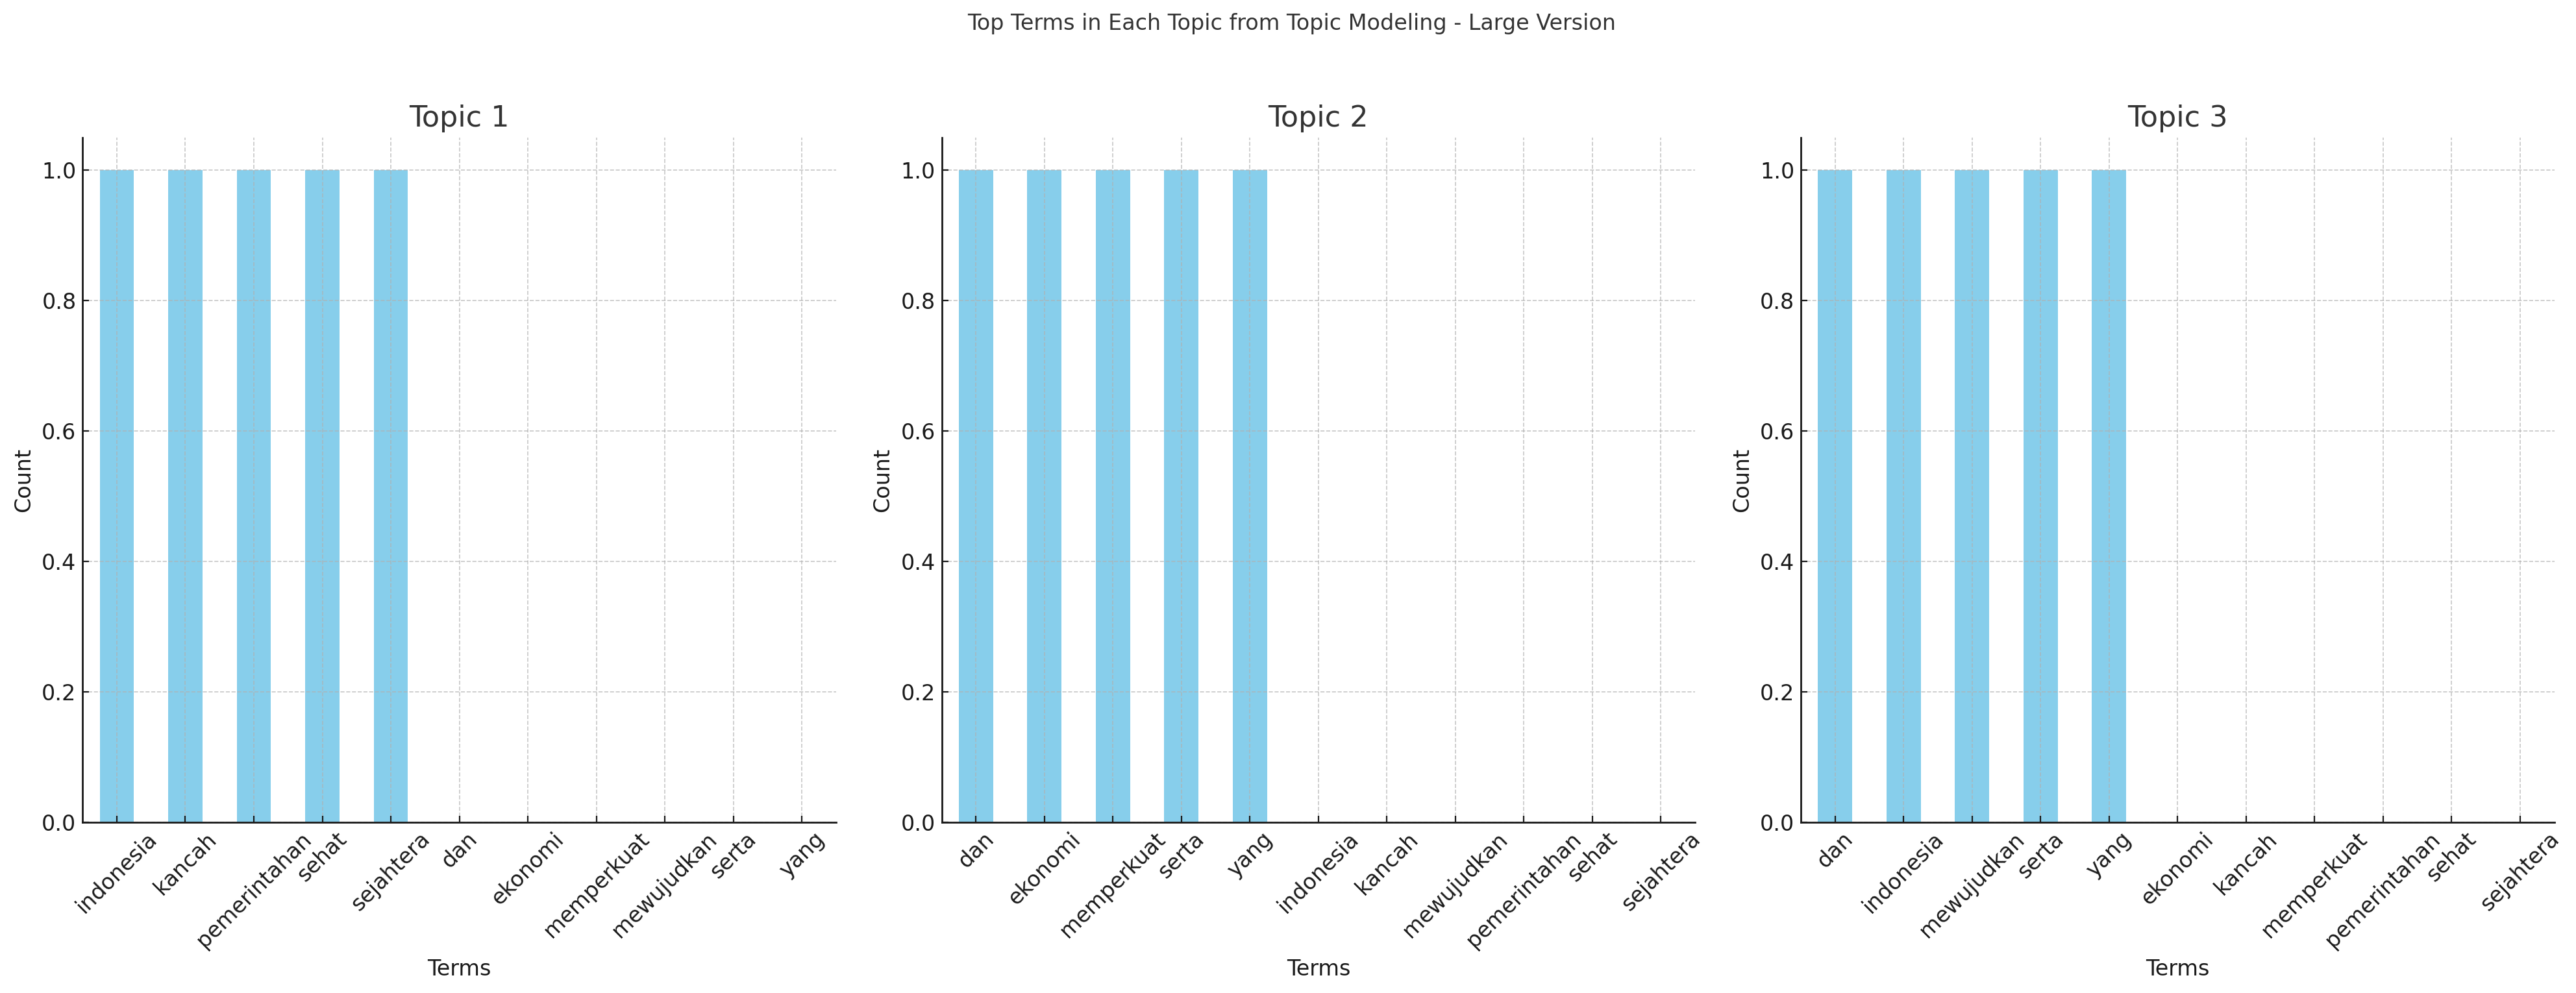
Melalui analisis ini, kita dapat memahami lebih jauh tentang fokus tematik dan prioritas yang berbeda dalam misi masing-masing blok. Ini memberikan wawasan tentang aspek-aspek yang dianggap penting oleh setiap blok dalam konteks politik atau sosial mereka.
Setelah melakukan analisis Latent Dirichlet Allocation (LDA) pada misi dari tiga blok politik yang berbeda, kita mendapatkan beberapa wawasan kunci:
-
Pembagian Topik: LDA berhasil mengidentifikasi topik-topik kunci dalam teks misi ketiga blok. Topik-topik ini mewakili tema atau fokus utama yang diungkapkan dalam misi masing-masing blok. Analisis menunjukkan perbedaan dalam prioritas dan fokus tematik antara blok-blok tersebut.
-
Karakteristik Topik:
- Topik 0 tampaknya berkaitan dengan aspek-aspek nasionalisme, kekuatan, dan ekonomi, dengan kata kunci seperti "Indonesia", "tangguh", dan "ekonomi".
- Topik 1 mencerminkan tema keadilan, inklusivitas, dan posisi global, ditandai dengan kata-kata seperti "mewujudkan", "global", dan "kancah".
- Topik 2 fokus pada pembangunan ekonomi, industri, dan kemajuan, dengan kata kunci seperti "ekonomi", "memperkuat", dan "mengembangkan".
- Distribusi Topik di Antara Blok:
- Dari visualisasi LDA, kita dapat melihat bahwa setiap blok memiliki tingkat asosiasi yang berbeda dengan topik-topik ini. Ini mengindikasikan bahwa walaupun mungkin ada beberapa kesamaan tematik, setiap blok memiliki cara penekanan dan pendekatan yang unik terhadap isu-isu tersebut.
- Beberapa blok mungkin lebih fokus pada aspek ekonomi dan industri (Topik 2), sementara yang lain mungkin lebih berfokus pada keadilan dan posisi global (Topik 1).
- Kesimpulan:
- Analisis LDA memberikan pandangan yang lebih sarat makna terhadap cara setiap blok politik mengartikulasikan visi dan misinya.
- Kita dapat menyimpulkan bahwa walaupun ada tema umum yang muncul di antara blok-blok politik, seperti fokus pada ekonomi, pembangunan, dan posisi Indonesia di panggung global, ada juga perbedaan yang signifikan dalam cara tema-tema ini dijelaskan dan diprioritaskan. Analisis ini membantu dalam menggali lebih dalam untuk memahami nuansa dan perbedaan dalam agenda politik setiap blok, yang bisa sangat berguna dalam konteks analisis politik dan sosial lebih luas.
Berdasarkan hasil Latent Dirichlet Allocation (LDA), kita dapat menentukan arah topik yang paling dominan untuk masing-masing blok politik:
- Blok A:
- Dominan dalam Topik 1 - Keadilan, Inklusivitas, Posisi Global.
- Ini menunjukkan bahwa misi Blok A lebih banyak berfokus pada tema keadilan sosial, inklusivitas, dan posisi Indonesia dalam konteks global.
- Blok B:
- Dominan dalam Topik 2 - Pembangunan Ekonomi, Industri, Kemajuan.
- Hal ini menunjukkan fokus Blok B pada pembangunan ekonomi dan industri, serta penekanan pada kemajuan dan inovasi.
- Blok C:
- Dominan dalam Topik 0 - Nasionalisme, Kekuatan, Ekonomi.
- Ini menandakan bahwa Blok C lebih mengutamakan aspek nasionalisme, kekuatan nasional, dan pembangunan ekonomi.
kode Python dan hasil eksekusi
# Menghitung topik dominan tiap blok berdasarkan skor topik tertinggi dari LD
dominant_topics = np.argmax(lda_features, axis=1)

# Membuat DataFrame untuk menampilkan topik dominan untuk setiap blok
dominant_topic_df = pd.DataFrame({'Block': block_names, 'Dominant Topic': dominant_topics})
dominant_topic_df['Topic Direction'] = dominant_topic_df['Dominant Topic'].map({
    0: 'Topik 0 - Nasionalisme, Kekuatan, Ekonomi',
    1: 'Topik 1 - Keadilan, Inklusivitas, Posisi Global',
    2: 'Topik 2 - Pembangunan Ekonomi, Industri, Kemajuan'
})

dominant_topic_df
Hasil eksekusi:
  Block  Dominant Topic                                    Topic Direction
0     A               1    Topik 1 - Keadilan, Inklusivitas, Posisi Global
1     B               2  Topik 2 - Pembangunan Ekonomi, Industri, Kemajuan
2     C               0          Topik 0 - Nasionalisme, Kekuatan, Ekonomi
Kesimpulan ini memberikan gambaran tentang prioritas dan fokus utama yang diungkapkan oleh masing-masing blok dalam misi mereka. Setiap blok memiliki ciri khasnya sendiri yang tercermin dalam topik-topik dominan yang teridentifikasi melalui analisis LDA.
Potensi Sesat-pikir (logical fallacy)
Berikut ini adalah telaah paling samar karena sangat tergantung konteks. Konteks ini yang dapat dimanfaatkan oleh blok lain untuk diangkat sebagai topik perdebatan. Kemungkinan sesat-pikir yang dapat dimanfaatkan masing-masing blok sejauh ini adalah:
- Blok A:
Overgeneralization: Jika ada klaim yang menyatakan keberhasilan dalam satu area (seperti kemandirian pangan) otomatis menyebabkan hasil positif di area lain (misalnya, mengentaskan kemiskinan), tanpa memberikan penjelasan yang memadai.Post Hoc Ergo Propter Hoc(Sebab Akibat yang Salah): Jika ada asumsi bahwa hanya karena satu kejadian mengikuti yang lain, itu harus menjadi penyebabnya. Misalnya, menganggap peningkatan kemandirian energi secara langsung mengurangi biaya hidup tanpa bukti yang cukup.
- Blok B:
False Dichotomy: Jika teks menyajikan ide bahwa satu-satunya cara untuk mencapai kemandirian bangsa adalah melalui swasembada pangan, energi, dan air, tanpa mempertimbangkan opsi lain.Circular Reasoning: Jika argumen dibuat bahwa pengembangan infrastruktur diperlukan untuk meningkatkan lapangan kerja, dengan asumsi bahwa lapangan kerja yang berkualitas hanya dapat dicapai melalui infrastruktur yang lebih baik, tanpa memberikan bukti eksternal.
- Blok C:
Slippery Slope: Jika ada pernyataan yang mengindikasikan bahwa satu kebijakan, seperti pengembangan ekosistem digital, akan secara tidak terhindarkan mengarah pada serangkaian peristiwa negatif atau positif tanpa bukti yang kuat.Appeal to Authority: Jika teks mengandalkan status atau otoritas Indonesia di kancah internasional sebagai alasan untuk mengejar kebijakan tertentu, tanpa memberikan bukti atau alasan substansial.
Identifikasi sesat-pikir bergantung pada tafsir dan konteks narasi teks secara keseluruhan. Kesalahan logika seringkali lebih mudah diidentifikasi dalam argumen dalam bahasa yang lebih terstruktur dan eksplisit.
Kesimpulan
- Hasil telaah menunjukkan kemiripan tetapi ada fokus dan prioritas yang unik untuk masing-masing blok.
- Blok A cenderung fokus pada
keadilandanmasalah luar negeri, Blok B padapembangunan ekonomidanindustri, sedangkan Blok C lebih menekankan padanasionalismedankemandirian ekonomi. - Visualisasi analisis memberikan gambaran bagaimana setiap blok berbeda atau mirip satu sama lain dalam pendekatan mereka terhadap isu-isu politik dan sosial.
- Setiap blok punya potensi sesat-pikir yang bisa diumbar (exploit) oleh kompetitor yang mahir mencari-cari konteks untuk menjatuhkan dalam perdebatan.
Bacaan acuan Machine Learning for Text.
